Loading…
함께 일하기
브라우저 자동화·기존 제품 AI 통합·프로덕션 릴리스 문제를 해결하는 시니어 제품/풀스택 엔지니어입니다. 정규직과 집중형 프로젝트 모두 가능합니다.
로스앤젤레스 · 전면 원격 · 미국 영주권자지금 바로 시작 가능
정규직
- 찾는 역할
- 시니어 소프트웨어 엔지니어 · AI 통합 / Applied AI 엔지니어 · 시니어 풀스택 / 자동화 엔지니어
- 근무 형태
- 전면 원격(미국, 태평양 표준시) · 영주권자(취업 스폰서 불필요)
- 가져오는 것
- 두 회사에서 5년 가까이 엔지니어링을 책임진 CTO 경험과 Playwright 자동화, AI 제품, PostgreSQL/Docker 프로덕션 시스템, CI/릴리스 게이트, RAG, 로컬 GPU 인프라를 직접 구축한 최근 경험.
집중형 엔지니어링 프로젝트
- 해결하는 문제
- Playwright/브라우저 자동화 · 기존 제품 AI 통합 · Next.js/PostgreSQL 릴리스·QA 구조화
- 규모 · 기간
- 원격 우선. 완료 기준과 증거가 명확한 유료 진단·구현 스프린트를 일 단위로 진행합니다.
- 시작하는 법
- 자동화·통합·릴리스 문제를 한 문단으로 보내주세요. 큰 계약 전에 작은 유료 진단부터 시작할 수 있습니다.
증거
19공개 데모·스토어가 있는 제품
6Play Store 앱
43총 빌드
관련 사례
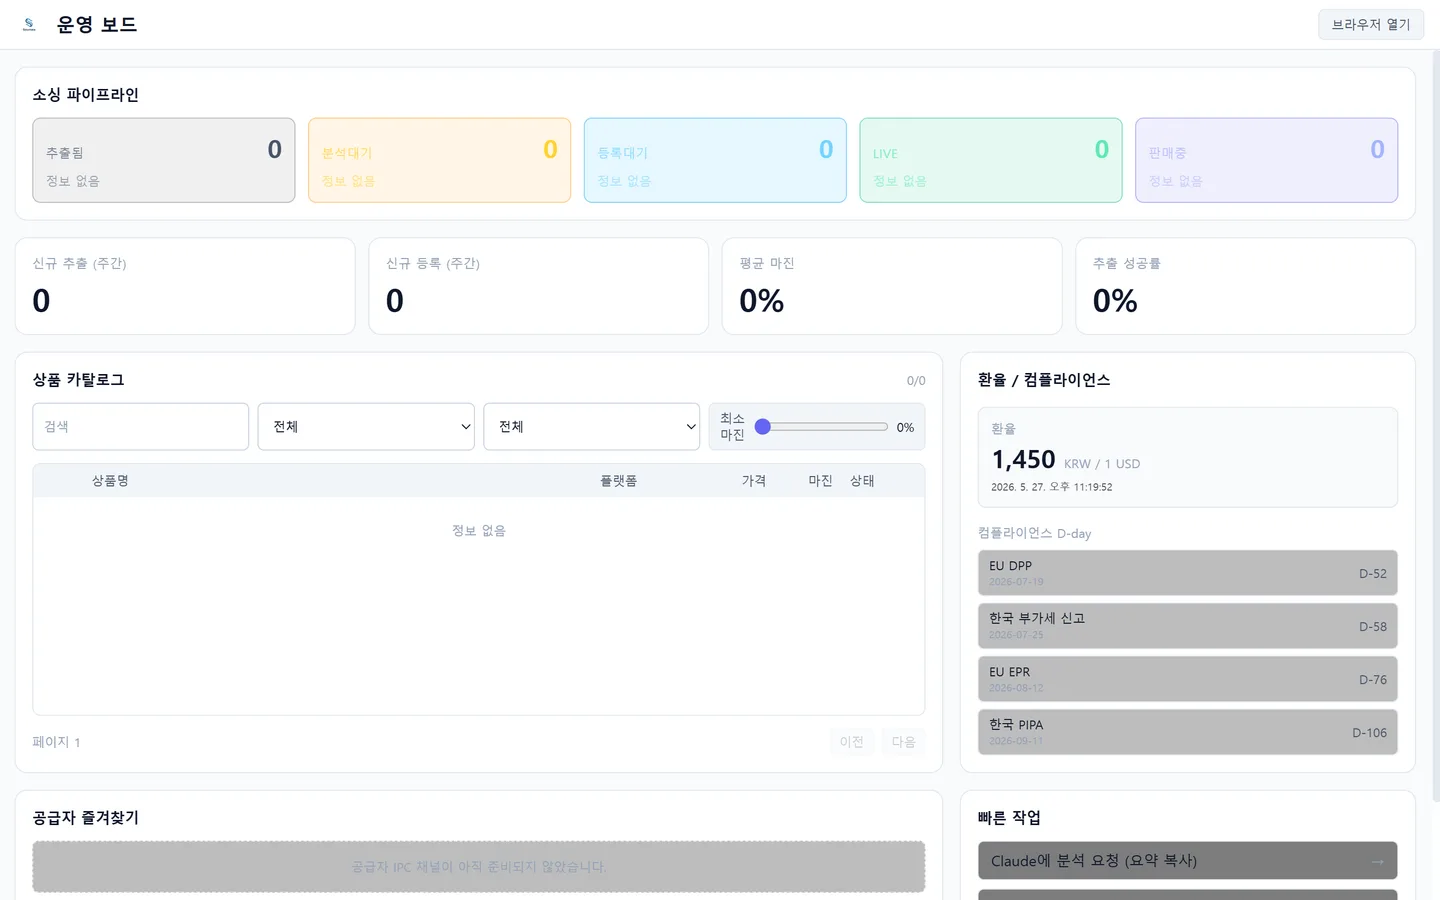
한국→미국 셀러용 Electron 소싱 데스크톱 도구. 내장 브라우저에서 공급처 페이지를 구조화된 로컬 상품 데이터로 추출하고, 운영 보드와 MCP를 통해 Claude Code 분석까지 연결합니다.
ElectronTypeScriptReactSQLitePlaywrightShopify Admin GraphQLClaude Code MCPGoogle Gemini AI
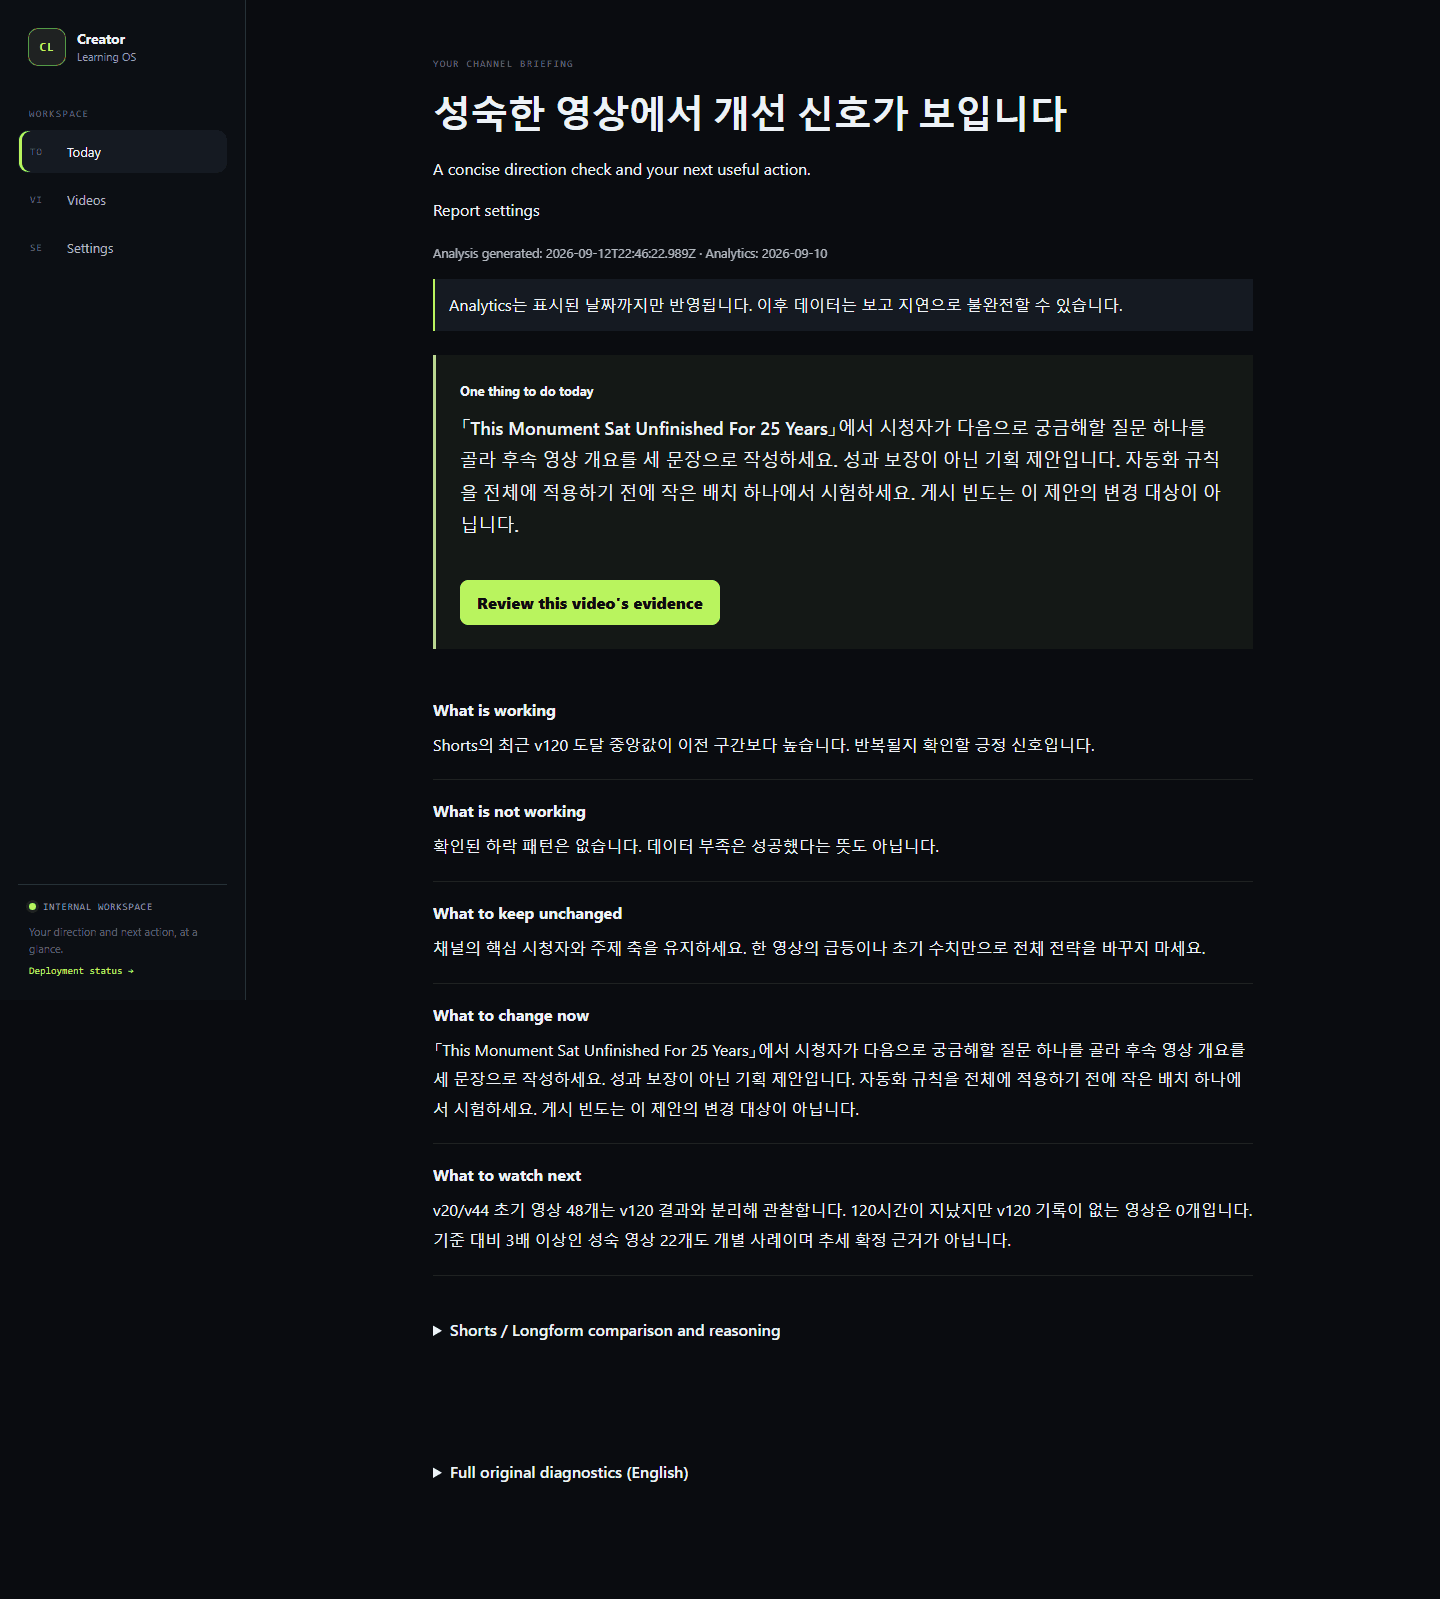
크리에이터·YouTube 리포팅 SaaS를 실제 고객 환경에 내보내기 전에 실패 폐쇄형 릴리스 게이트로 단단하게 만든 production-hardening 프로젝트. PostgreSQL 워커, Docker 런타임, 백업·복구, Playwright QA와 운영 프리플라이트를 한 릴리스 계약으로 묶었습니다.
Next.jsTypeScriptPostgreSQLDockerPlaywrightVitestBetter AuthYouTube API
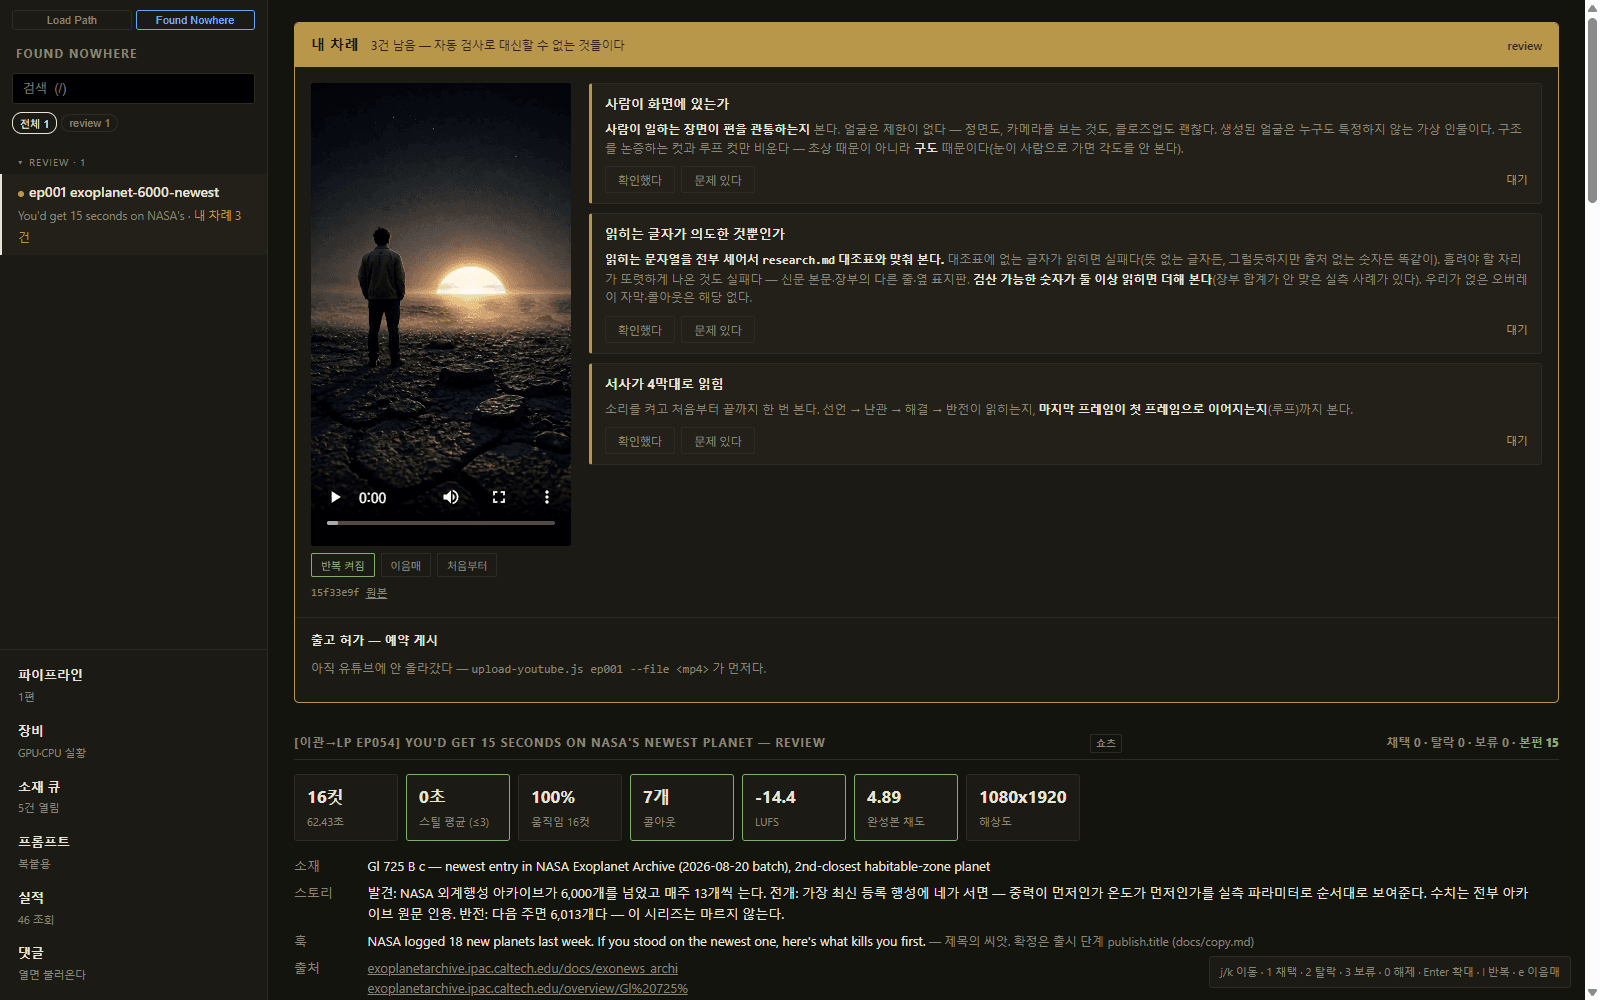
기록에 난관과 해결이 남아 있는 대상을 골라 영어권 유튜브 숏츠로 만드는 제작 파이프라인. 영상과 음성 자산은 전부 로컬 생성 팩토리(studios)에서 나오고, 이 레포는 자산을 복제하지 않고 id로만 참조하면서 지금 어느 단계인지, 무엇이 왜 탈락했는지라는 상태만 파일로 관리합니다. 후보에서 게시까지 7단계를 두고 단계마다 게이트를 걸었습니다. 출처 두 개 이상과 나레이션 문장 수만큼의 사실 대조표, 그리고 쓰지 않기로 한 숫자까지 적어야 사실 대조가 끝나고, 컷 평균 3초 이하와 라우드니스 -14 LUFS를 통과해야 검토로 넘어가며, 제작 승인만은 자동화하지 않고 사람이 누릅니다. 조립·컷·오버레이·자막·색보정·효과음·업로드를 Node 도구 사슬로 묶고, 공개 뒤에는 YouTube Data API로 실적을 스냅샷으로 받아 다음 편 설계의 근거로 씁니다. 첫 측정에서 조회의 98.8%가 숏츠 피드에서 오고 검색은 0.4%였다는 것, 그리고 더 많이 본 편이 오히려 첫 몇 초에서 시청자를 더 많이 잃었다는 부정 결과를 그대로 기록했습니다. 처음엔 r/todayilearned 소재로 시작했지만 고정 4막(대상, 난관, 발상 전환, 탄생)이 성립하려면 소재 자체에 난관과 해결이 있어야 한다는 걸 확인하고 소재 조건을 다시 정의했습니다.
JavaScriptNode.jsFFmpegYouTube Data APIModel Context Protocol
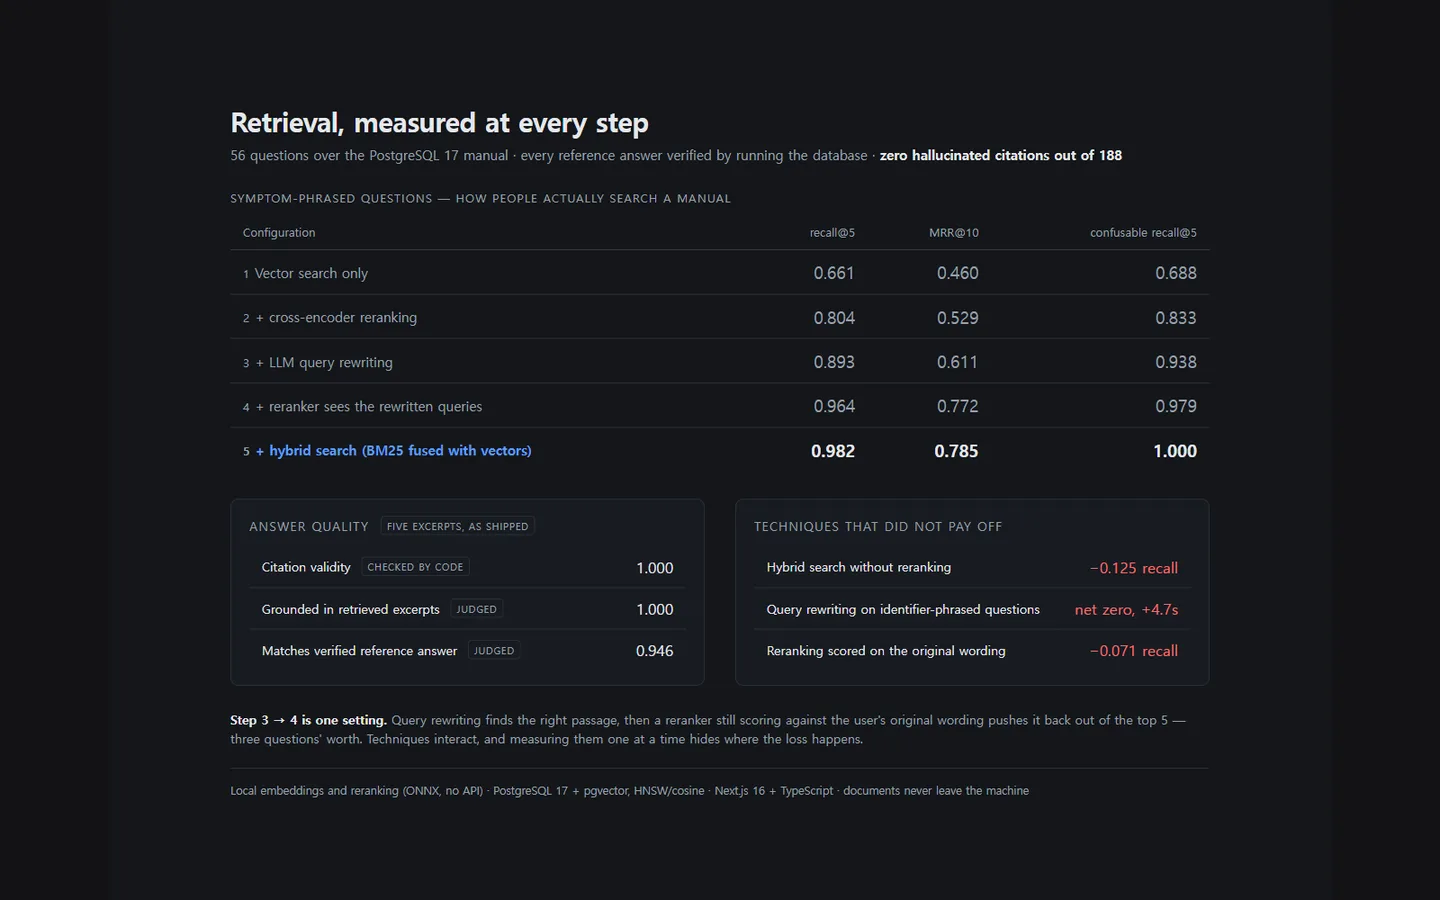
문서 기반 질의응답(RAG)에서 인용을 화면에 내보내기 전에 검색된 청크와 대조해 검증하고, 검색 품질을 주장이 아니라 측정으로 답하는 시스템. pg_dump와 pg_dumpall, 다섯 종류의 work_mem 설정처럼 거의 똑같아 보이는 문단이 가득한 PostgreSQL 17 공식 매뉴얼 약 3,000쪽을 코퍼스로 골라, 순진한 벡터 검색이 조용히 엉뚱한 문단을 돌려주는 지점을 드러냈습니다. 46개 질문 평가에서 크로스 인코더 재순위화를 켜면 recall@5 0.978, MRR@10 0.834로 평문 벡터 검색의 0.652를 크게 웃돌고, 인용 유효성은 1.000으로 168건 중 환각 인용이 0건입니다. 임베딩과 재순위화가 로컬 ONNX로 돌아 색인 단계에는 외부 호출이 전혀 없습니다.
TypeScriptNext.jsReactPostgreSQLpgvectorTransformers.jsONNX RuntimeAnthropic API
기술 스택
프론트엔드
ReactNext.jsTypeScriptTailwind CSSElectronReact NativeThree.jsWebAssemblyUnreal Engine
백엔드
NestJSNode.jsPythonFastAPISupabasePostgreSQLPrismaDrizzle ORMpgvectorRedis
도구
GitDockerVercelStripePlaywrightGoogle GeminiClaude APIModel Context ProtocolTurborepo
인프라
TailscaleCaddyOracle CloudInfisicalUptime KumaOllama