Loading…
프로젝트 목록으로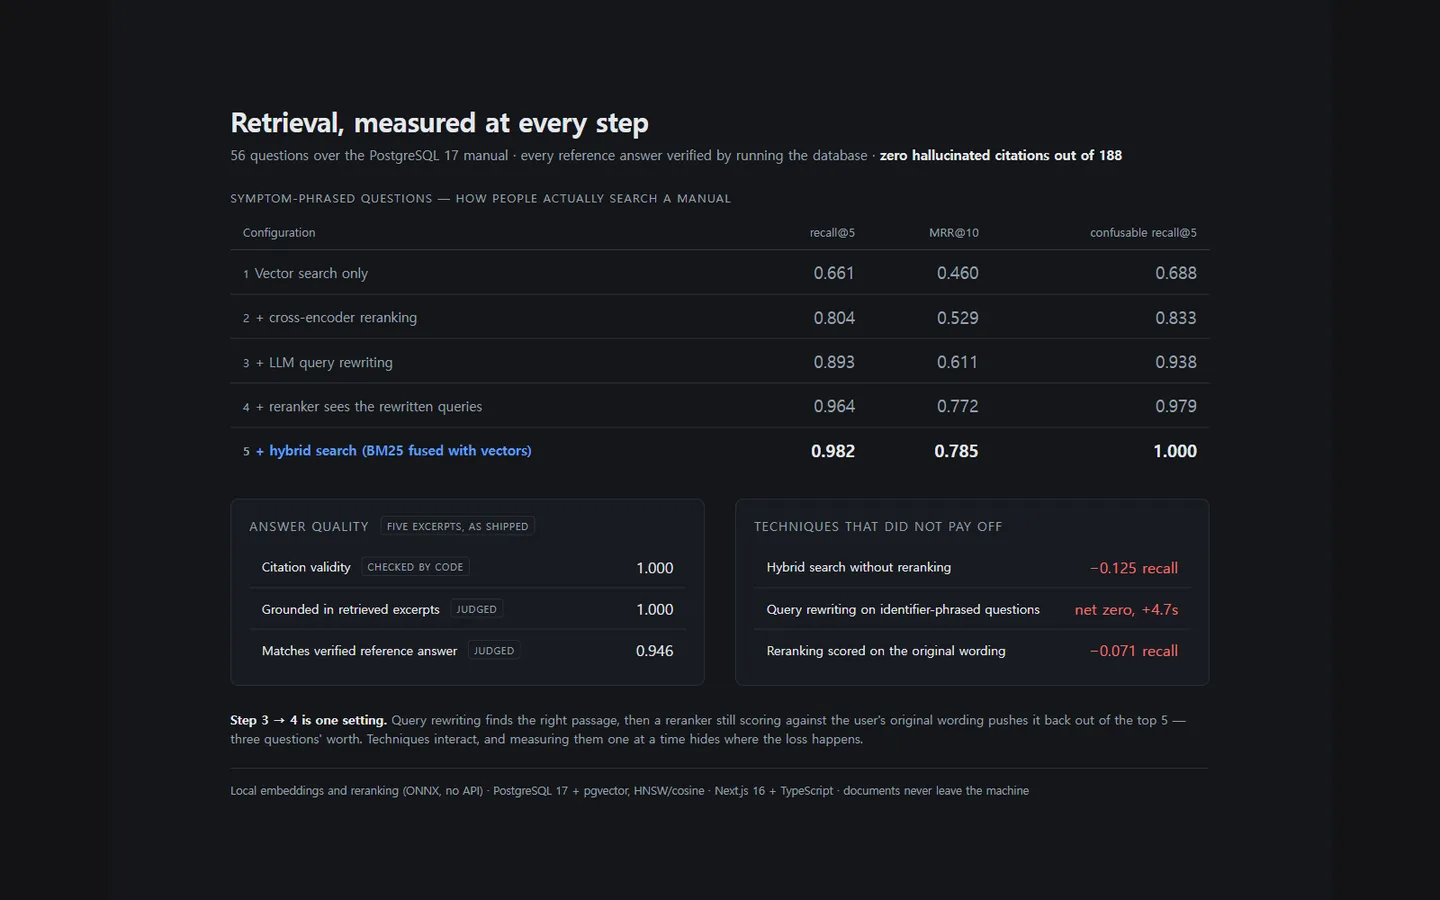
citefirst
활성문서 기반 질의응답(RAG)에서 인용을 화면에 내보내기 전에 검색된 청크와 대조해 검증하고, 검색 품질을 주장이 아니라 측정으로 답하는 시스템. pg_dump와 pg_dumpall, 다섯 종류의 work_mem 설정처럼 거의 똑같아 보이는 문단이 가득한 PostgreSQL 17 공식 매뉴얼 약 3,000쪽을 코퍼스로 골라, 순진한 벡터 검색이 조용히 엉뚱한 문단을 돌려주는 지점을 드러냈습니다. 46개 질문 평가에서 크로스 인코더 재순위화를 켜면 recall@5 0.978, MRR@10 0.834로 평문 벡터 검색의 0.652를 크게 웃돌고, 인용 유효성은 1.000으로 168건 중 환각 인용이 0건입니다. 임베딩과 재순위화가 로컬 ONNX로 돌아 색인 단계에는 외부 호출이 전혀 없습니다.
TypeScriptNext.jsReactPostgreSQLpgvectorTransformers.jsONNX RuntimeAnthropic API
어떻게 풀었는가
문제
RAG가 인용을 붙였다는 사실만으로는 그 인용이 검색 청크를 지지하는지, 검색 자체가 맞았는지 알 수 없습니다.
결정
PostgreSQL 17 매뉴얼처럼 유사 문단이 많은 코퍼스를 평가셋으로 삼고 로컬 임베딩·크로스 인코더 재순위화·출력 전 인용 검증을 분리해 측정했습니다.
증거
46개 평가 질문에서 재순위화 구성은 recall@5 0.978, MRR@10 0.834를 기록했고 인용 유효성은 1.000으로 168건 중 환각 인용이 0건이었습니다.
결과
검색 품질과 인용 정확도를 반복 가능한 수치로 비교할 수 있는 RAG 평가·검증 시스템이 됐습니다.