Loading…
프로젝트 목록으로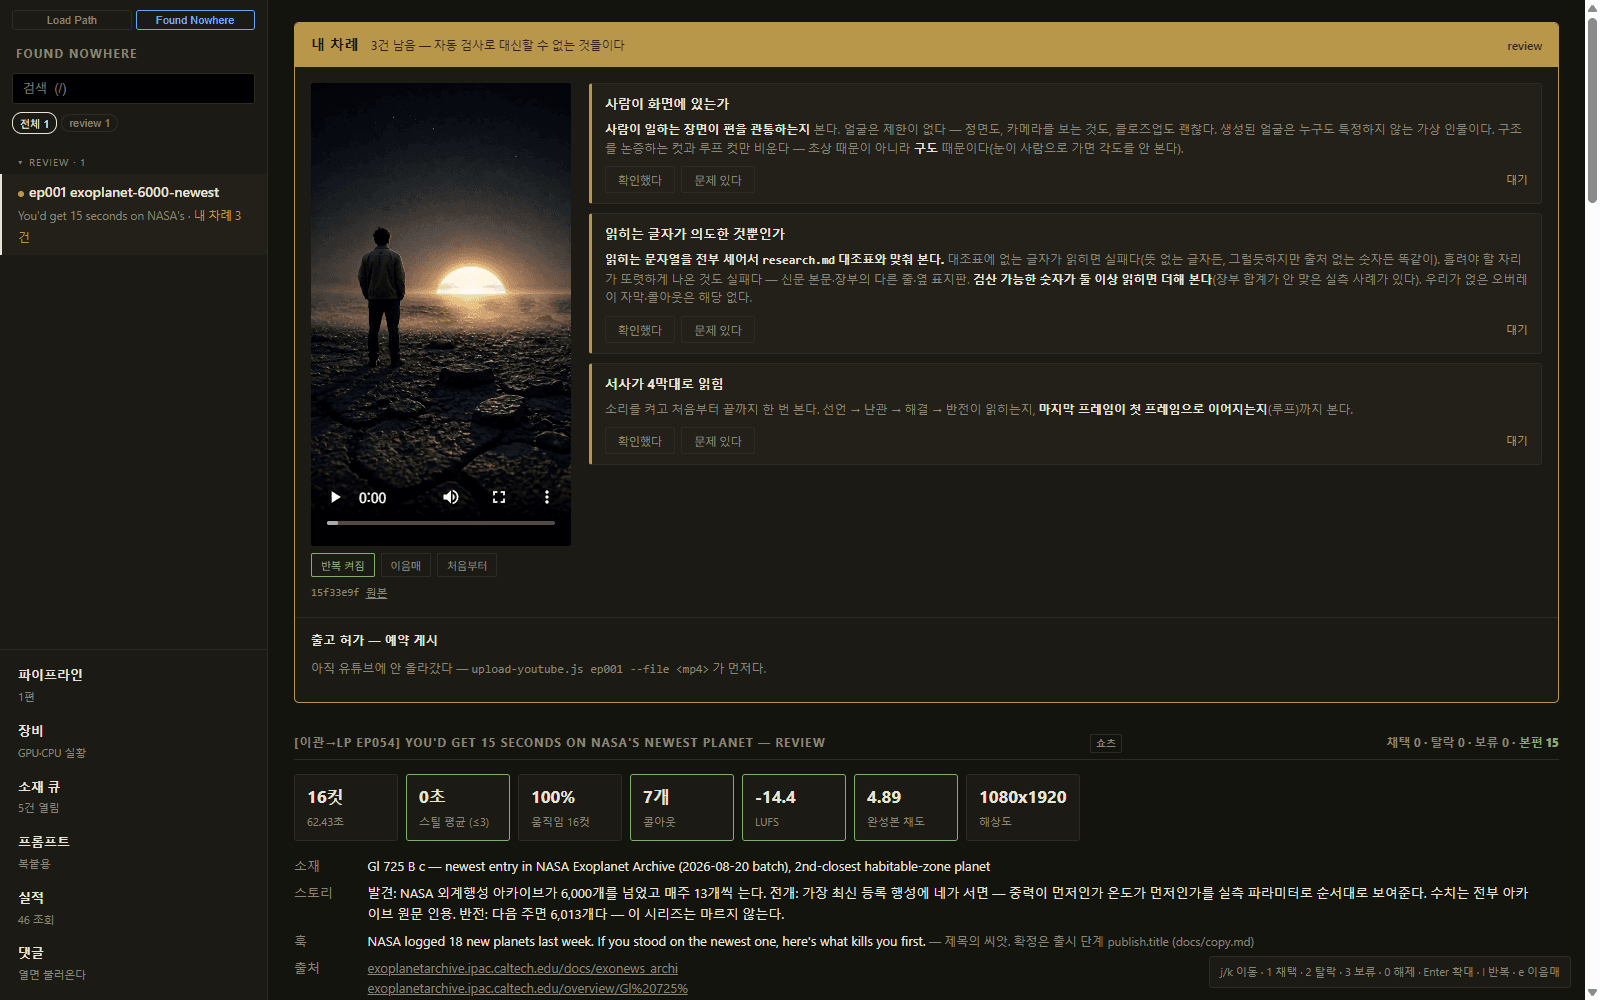
til-shorts
활성 비공개기록에 난관과 해결이 남아 있는 대상을 골라 영어권 유튜브 숏츠로 만드는 제작 파이프라인. 영상과 음성 자산은 전부 로컬 생성 팩토리(studios)에서 나오고, 이 레포는 자산을 복제하지 않고 id로만 참조하면서 지금 어느 단계인지, 무엇이 왜 탈락했는지라는 상태만 파일로 관리합니다. 후보에서 게시까지 7단계를 두고 단계마다 게이트를 걸었습니다. 출처 두 개 이상과 나레이션 문장 수만큼의 사실 대조표, 그리고 쓰지 않기로 한 숫자까지 적어야 사실 대조가 끝나고, 컷 평균 3초 이하와 라우드니스 -14 LUFS를 통과해야 검토로 넘어가며, 제작 승인만은 자동화하지 않고 사람이 누릅니다. 조립·컷·오버레이·자막·색보정·효과음·업로드를 Node 도구 사슬로 묶고, 공개 뒤에는 YouTube Data API로 실적을 스냅샷으로 받아 다음 편 설계의 근거로 씁니다. 첫 측정에서 조회의 98.8%가 숏츠 피드에서 오고 검색은 0.4%였다는 것, 그리고 더 많이 본 편이 오히려 첫 몇 초에서 시청자를 더 많이 잃었다는 부정 결과를 그대로 기록했습니다. 처음엔 r/todayilearned 소재로 시작했지만 고정 4막(대상, 난관, 발상 전환, 탄생)이 성립하려면 소재 자체에 난관과 해결이 있어야 한다는 걸 확인하고 소재 조건을 다시 정의했습니다.
JavaScriptNode.jsFFmpegYouTube Data APIModel Context Protocol
어떻게 풀었는가
문제
AI로 영상·음성 자산을 빨리 만들 수 있어도, 사실 대조·컷 품질·오디오 기준·사람 검수·업로드 상태가 서로 다른 곳에 흩어지면 대량 제작은 쉽게 잘못된 영상을 더 빨리 내보내는 시스템이 됩니다.
결정
에피소드 상태를 파일 기반 원장으로 두고 dispatch → 생성 → 조립 → QA → 사람 검수 → 업로드 → 성과수집을 Node 도구 체인으로 묶었습니다. 자동 게이트가 통과해도 최종 제작 승인은 사람이 하며, 탈락 이유와 미완료 상태를 성공으로 덮어쓰지 않도록 했습니다.
증거
현재 커밋에는 dispatch.js, assemble.js, qa.js, upload-youtube.js, analytics.js와 gates/retry/chain 모듈이 함께 있으며 smoke·recipe·QA·analytics 테스트가 이 경계를 검증합니다. 운영 대시보드도 실제 검수·출고 허가·장비·소재 큐 상태를 같은 원장에서 읽습니다.
결과
생성 모델 하나에 종속된 데모가 아니라, 실패·재시도·검수·사람 승인·YouTube 성과 피드백을 추적할 수 있는 실제 콘텐츠 운영 파이프라인으로 발전했습니다. 최신 병렬 개발 중인 supervisor/quota 기능은 이 사례의 완료 근거로 선반영하지 않았습니다.